Bei den aktuellen Entwicklungen im Bereich der großen Sprachmodelle (Large Language Models, LLMs) scheint das Thema Datenqualität oft weniger im Fokus zu stehen. Das liegt daran, dass diese Sprachmodelle mit einem in finanzieller Hinsicht enormen Aufwand trainiert werden. Mithilfe des sogenannten self-supervised Pretrainings und großer (und damit kostspieliger) Rechenleistung können gigantische Textmengen für das Training verwendet werden. Das Verfahren ermöglicht es, aus den Daten automatisiert ein sogenanntes Label zu generieren – ohne menschliches Eingreifen. Beispielsweise wird ein einzelnes Wort aus einem Satz ausgeblendet und das Modell muss anschließend rekonstruieren, welches Wort die entstandene Lücke füllen könnte. Mit dieser Kombination aus großen Datenmengen, großer Rechenleistung und einem Trainingsansatz, der quasi eine Vollautomatisierung des Trainings ermöglicht, spielt Datenqualität tatsächlich nur noch eine untergeordnete Rolle. Denn grundsätzlich gilt, dass die Bedeutung der Datenqualität mit steigender Datenmenge abnimmt.
Mit dem Blick auf spezifischere Use Cases mit kleineren Datensätzen, die aufgrund wesentlich geringerer Trainingskosten gerade für kleine und mittlere Unternehmen hierzulande attraktiv sein können, gewinnt das Thema Datenqualität an Bedeutung. Da hier weniger Daten zur Verfügung stehen, um eine gute Performance zu erzielen, ist zu beachten, dass der Mangel an Daten von der Datenqualität ausgeglichen wird. Wenige Daten in einer schlechten Qualität sind eine wenig aussichtsreiche Kombination für Machine Learning.
Daten als Ausschnitt der Realität
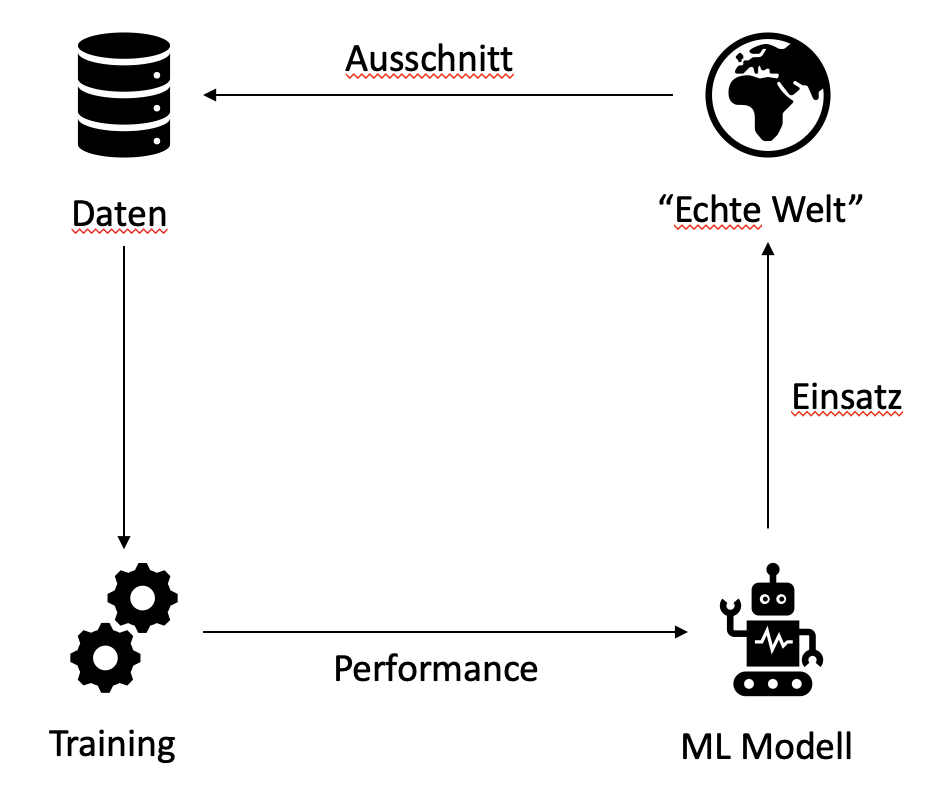
Die Bedeutung der Datenqualität nimmt mit steigender Datenmenge ab, da zugleich die Wahrscheinlichkeit steigt, dass die Realität besser abgebildet wird. Datensätze sind jedoch immer nur ein Ausschnitt der Realität. Die Idee von Machine Learning ist, ein Modell mit einem Datensatz zu trainieren, der einer realen Wahrscheinlichkeitsverteilung möglichst nahe kommt. Leider ist diese Anforderung in den vielen Fällen nicht ganz haltbar, denn Machine-Learning-Anwendungsfälle sind oft zu komplex, als dass ein Datensatz die reale Verteilung wirklich abbilden kann.
Das Ziel eines Datensatzes, der für den KI Einsatz genutzt werden soll, muss also sein, mit der begrenzten Menge an Trainingsbeispielen möglichst nah an die reale Verteilung zu kommen. Bei enorm großen Trainingsdatensätzen ist das wahrscheinlicher, weil hier in der Regel sehr viele verschiedene Trainingsbeispiele enthalten sind. Bei kleineren Datensätzen hingegen besteht ein höheres Risiko, dass nicht genügend verschiedene Trainingsbeispiele enthalten sind oder bestimmte Trainingsbeispiele fehlen. Dann kann es sein, dass das Modell während des Trainings nicht das lernt, was es für den realen Einsatz benötigt, und die Performance unter den Erwartungen bleibt. Die Digitalisierungs- und Automatisierungslösungen von Retarus ermöglichen effiziente Abläufe ohne manuellen Aufwand oder Kompromisse bei der Datensouveränität ‣ weiterlesen
Business Process Solutions
Retarus beschleunigt Datenaustausch in der Produktion
Was Datenqualität bedeutet
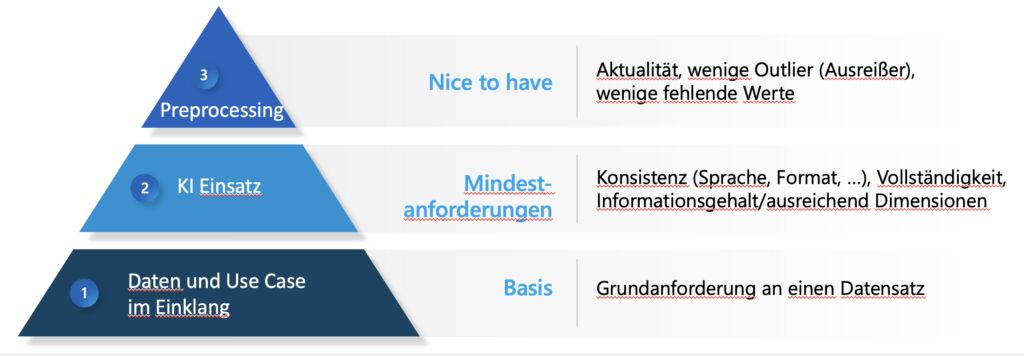
Im Grunde basieren die Anforderungen an die Qualität eines Datensatzes darauf, dass die reale Verteilung möglichst gut im Datensatz abgebildet wird. Dazu braucht es in erster Linie eine Übereinstimmung der Daten und des Use Cases. Vereinfacht formuliert bringt es nichts, etwa ein KI-Modell mit Katzenbildern darauf zu trainieren, Hunderassen zu erkennen. In der Übereinstimmung von Daten und Use Case liegt somit die Basis für die Datenqualität in den meisten Machine Learning Anwendungen.
Der Informationsgehalt der Daten ist ein weiterer wichtiger Baustein einer guten Datenqualität. Denn die müssen auch die Informationen enthalten, mit denen dann etwa eine Vorhersage oder Entscheidung mit entsprechender Konfidenz getroffen werden kann. Im Beispiel der Hunderassenerkennung würde es wahrscheinlich wenig bringen, wenn auf den Hundebildern nur ein Ausschnitt des Kopfes zu sehen wäre. Andere wichtige Informationen wie beispielsweise das Fell, Fellfarbe, Körperbau oder der Schwanz fehlen.
Zu einem guten Datensatz gehört darüber hinaus auch gewisse Balance. Wenn etwa 90 Prozent der Hundebilder die Rasse ‚Schäferhund‘ abbilden und nur die restlichen 10 Prozent andere Hunderassen, dann wird das Modell auch hier vermutlich in vielen Fällen schlecht performen. Es gilt, den Datensatz so ausgewogen wie möglich zu gestalten. Gleichzeitig müssen jedoch genügend Trainingsbeispiele der einzelnen Hunderassen enthalten sein. Ein fiktiver Trainingsdatensatz mit einem Bild pro Hunderasse ist zwar balanciert, wird aber dennoch nicht weit führen.
Zuletzt sollte man noch ein paar allgemeine Anforderungen an einen Datensatz stellen, um von guter Datenqualität sprechen zu können. Und zwar sollten die Daten konsistent z.B. in Bezug auf Format oder Sprache, möglichst aktuell und weitestgehend vollständig sein. Auch sogenannte Outlier oder Biases können zum Problem werden und sollten daher im Idealfall vermieden werden. Da sich dies jedoch nicht immer beeinflussen lässt, machen diese Faktoren eher den Unterschied zwischen sehr guten und guten Daten, stellen aber in der Regel keine großen Hindernisse dar. Lediglich der Aufwand während des sogenannten Preprocessings (Vorbereiten der Daten für das ML Modell) wird erhöht.
Fazit
Ohne gute Datenqualität wird es kaum gelingen, eigene Machine Learning Modelle effektiv und profitabel einzusetzen. Daher ist es umso wichtiger, dass die Datengrundlage stimmt. Auch wenn die Anforderungen an die Datenqualität auf den ersten Blick zahlreich und komplex scheinen, bietet eine gute Datengrundlage zumindest die Möglichkeiten, die Datenqualität zu verbessern. Es gibt Möglichkeiten, Outlier oder fehlende Werte im Datensatz zu behandeln. Zudem ist es möglich, dass Menschen zusätzliche Trainingsbeispiele erstellen oder vorhandene erweitern. Es gilt, eine solide Datengrundlage oder zumindest Datenquellen zu schaffen, um überhaupt Möglichkeiten für den KI Einsatz ergreifen zu können.