Ziel des Innovationsprojekts ist es, den Zusammenhang zwischen der Stammdatenqualität und der Performance der Auftragsabwicklung datenbasiert am Beispiel der Sollzeiten von Arbeitsplänen aufzuzeigen. Sind diese fehlerhaft, führt dies zu Fehlplanungen, welche die Auftragsabwicklung beeinträchtigen. Sollzeiten bestimmen, wie realistisch Aufträge terminiert, Liefertermine gehalten und wie effizient Kapazitäten ausgelastet werden. Sind sie ungenau, veraltet oder inkonsistent, entsteht selten ein klarer Fehler, sondern schleichende Ineffizienz. Zu kurze Sollzeiten lassen die Planung hoch ausgelastet wirken, während die Fertigung real nicht hinterherkommt. Aufträge stauen sich und Liefertermine können nicht eingehalten werden. Zu großzügige Sollzeiten lassen Kapazitäten unbemerkt ungenutzt. Wie stark sich das auswirkt, hängt zudem vom Kontext ab, etwa vom Schichtmodell oder saisonalen Auslastungsspitzen.
Von der Kennzahl zum Tool
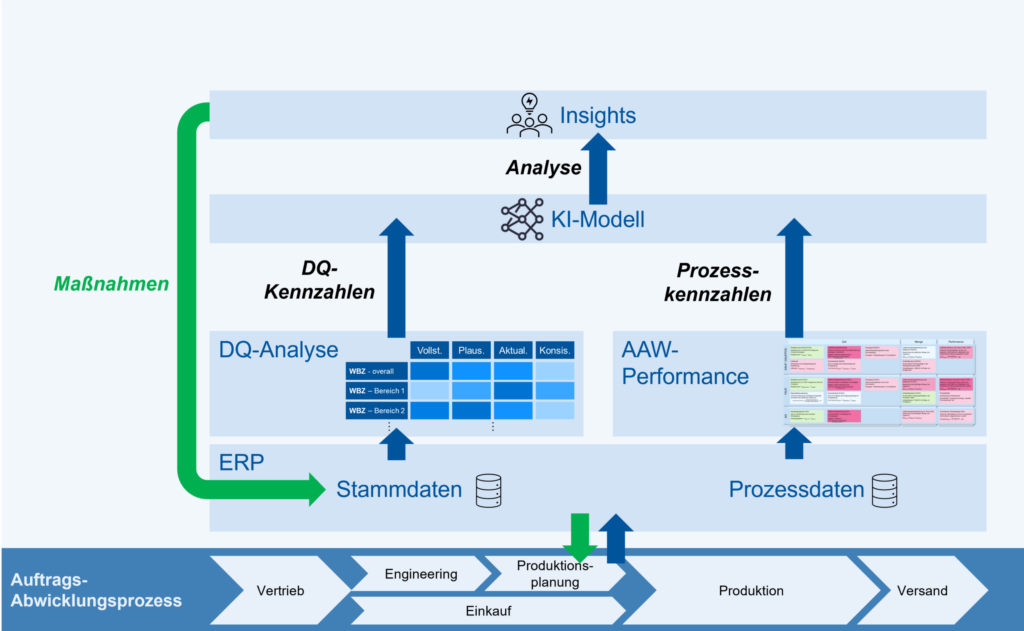
Die Entwicklung des Analyseframeworks beinhaltete die Definition von Datenqualitätsdimensionen für Sollzeiten mit einer Berechnungslogik und die Herleitung geeigneter Performancekennzahlen der Auftragsabwickelung. Zudem wurde eine Analysemethodik aufgebaut, um den Zusammenhang zwischen den Datenqualitätsdimensionen und den Performancekennzahlen mit Statistik und Machine Learning wie Entscheidungsbäumen zu quantifizieren und mit realen ERP-Daten in einem eigens entwickelten Tool zu pilotieren.
Das Team definierte verschiedene Datenqualitätsdimensionen, von Korrektheit über Vollständigkeit bis Verständlichkeit. Für die spätere Analyse wurden diese entsprechend ihrer Relevanz gewichtet, wobei die Korrektheit, Aktualität und Konsistenz als am relevantesten bewertet wurden. Zusätzlich wurden die Performancekennzahlen auf den Ebenen Kundenauftrag, Fertigungsauftrag und Arbeitsgang definiert, beispielsweise Arbeitsgangdauer, Durchlaufzeit oder Liefertermintreue.
Das im Rahmen des Projekts entwickelte Tool stellt eine Datenqualitätsdimension als erklärende Variable einer Performancekennzahlen gegenüber und quantifiziert den Zusammenhang. Bei der Anwendung laden Nutzende eine CSV-Datei hoch, führen ein Datenfeld-Mapping durch und erhalten Kennzahlen, Korrelationen und Datenqualitätsklassen.
Was die Daten zeigen
Mit den von produzierenden Unternehmen bereitgestellten Datensätzen konnte nur ein Teil der ausgewählten Datenqualitätsdimensionen und Performancekennzahlen analysiert werden, da Buchungslücken bei Ist-Zeiten bestanden oder diese teilweise nachträglich durch retrograde Buchungen an die Soll-Zeiten angeglichen wurden. Die Erkenntnis daraus: Wer die Stammdatenqualität messen will, braucht verlässliche Ist-Daten.
Beide Datensätze zeigen jedoch einen nachweisbaren Zusammenhang zwischen der Stammdatenqualität und den Performancekennzahlen der Auftragsabwicklung, wobei die Konsistenz und Korrektheit die Datenqualitätsdimensionen mit dem größten Einflussfaktor sind. Aufträge mit besserer Datenqualität sind messbar produktiver. Im ersten Datensatz können fünf bis zehn Prozent der Produktivitätsunterschiede auf die Stammdatenqualität zurückgeführt werden. Im zweiten Datensatz war das Signal mit 22 Prozent sogar noch deutlicher. Der Einfluss ist somit real und messbar, wird aber stets von weiteren Faktoren überlagert. Auch dass viele Kriterien kein Signal zeigten, ist kein Gegenbeweis, da Erfassungslücken reale Zusammenhänge verdecken können.
Drei Ebenen
Der abgeleitete Maßnahmenkatalog reagiert auf drei Problemdimensionen im Stammdatenmanagement:
- fehlende organisatorische Verankerung,
- unzureichende systemische Unterstützung über den Produktlebenszyklus und
- mangelnde Rückkopplung aus der Ausführung.
Da Maßnahmen, die nur auf eine der drei Problemdimensionen abzielen, oft ohne nachhaltige Wirkung bleiben, haben die Projektbeteiligten Maßnahmen entwickelt, die gemeinsam alle drei Ebenen adressieren.
Stammdatenmanagement ist oft nur Nebenaufgabe von Fachbereichsleitenden. Mangelnde interne Kapazität sind der häufigste Grund für das Scheitern von Stammdatenprojekten. Empfohlen wird mindestens eine verantwortliche Person, fachlich verankert in Konstruktion, Arbeitsvorbereitung oder Produktion, mit klarem Mandat für Pflege und Review. Die Kosten sind gegen die unsichtbaren Reibungsverluste schlechter Stammdatenqualität abzuwägen und fallen meist zugunsten der Ressource aus.
Das ERP bleibt meist das zentrale System für die Stammdatenpflege, stößt jedoch bei komplexen Produktstrukturen oder häufigen Änderungen an seine Grenzen. Hier wird ein integriertes PLM-System zum Datenmanagement über den gesamten Produktlebenszyklus empfohlen. Dieses dient als Single Source of Truth für produktbeschreibende Stammdaten, mit Versionierung und der Möglichkeit, Produktänderungen systematisch in Arbeitspläne und Stücklisten zurückzuspielen.
Sollzeiten können nur so aktuell bleiben, wie die Rückmeldedaten es zulassen. Deshalb wird empfohlen, basierend auf einer verlässlichen, echtzeitnahen Datenerfassung einen Review-Auftrag auszulösen, wenn systematische Abweichungen der Ist-Zeiten vorliegen.
Fazit
Das Projekt hat gezeigt, dass die Stammdatenqualität ein realer und gezielt adressierbarer Hebel ist, um die Performance der Auftragsabwicklung zu verbessern. Ebenso entscheidend ist die Qualität der Rückmeldedaten, denn ohne verlässliche Ist-Daten misst man eher Erfassungslücken als die tatsächliche Datenqualität. Unternehmen sollten diesen Hebel deshalb aktiv nutzen und Stammdatenqualität nicht als IT-Randthema behandeln, sondern gezielt mit klarer organisatorischer Verantwortung, durchgängiger Systemarchitektur und echter Rückkopplung aus der Fertigung angehen.