Während große Sprachmodelle (LLMs) durch ihre reine Größe und breiten Einsatzmöglichkeiten beeindrucken, stoßen sie in produktionsnahen Szenarien oft an Grenzen – etwa bei Echtzeitanforderungen. Kleine Sprachmodelle setzen genau hier an und bringen KI dort ins Spiel, wo sie bisher nicht praktikabel war. NTT Data, ein Anbieter von KI sowie digitalen Business- und Technologie-Services, beantwortet im folgenden Beitrag, was IT-Verantwortliche in der Industrie über Small Language Models (SLMs) wissen sollten.
Worin unterscheiden sich SLMs von großen KI-Modellen?
Small Language Models sind deutlich kompakter aufgebaut als LLMs – sie umfassen typischerweise zwischen 100 Millionen und 10 Milliarden Parameter. Zum Vergleich: GPT-4 verfügt je nach Architektur über mehrere hundert Milliarden Parameter. Als Parameter werden interne Variablen wie Gewichtungen und Verzerrungen bezeichnet, die ein Modell während des Trainings erlernt. Der reduzierte Umfang eines SLMs hat konkrete Auswirkungen auf die Laufzeitumgebung, die Inferenzgeschwindigkeit und den Speicherbedarf: Kleine Sprachmodelle benötigen weniger Rechenleistung, verbrauchen weniger Energie und lassen sich schneller trainieren. Diese Effizienz geht jedoch nicht zu Lasten der Leistung. Laut NTT Data-Pressemitteilung erreicht etwa das Phi-2-Modell von Microsoft mit gerade einmal 2,7 Milliarden Parametern beim Commonsense Reasoning Ergebnisse, die mit zehnmal so großen Modellen vergleichbar sind. Das Phi-4-Mini-Reasoning-Modell mit nur 3,8 Milliarden Parametern erzielt bei mathematischen Problemlösungen bessere Resultate als viele der großen Modelle.
Wie profitieren Industrieunternehmen vom Einsatz kompakter Modelle?
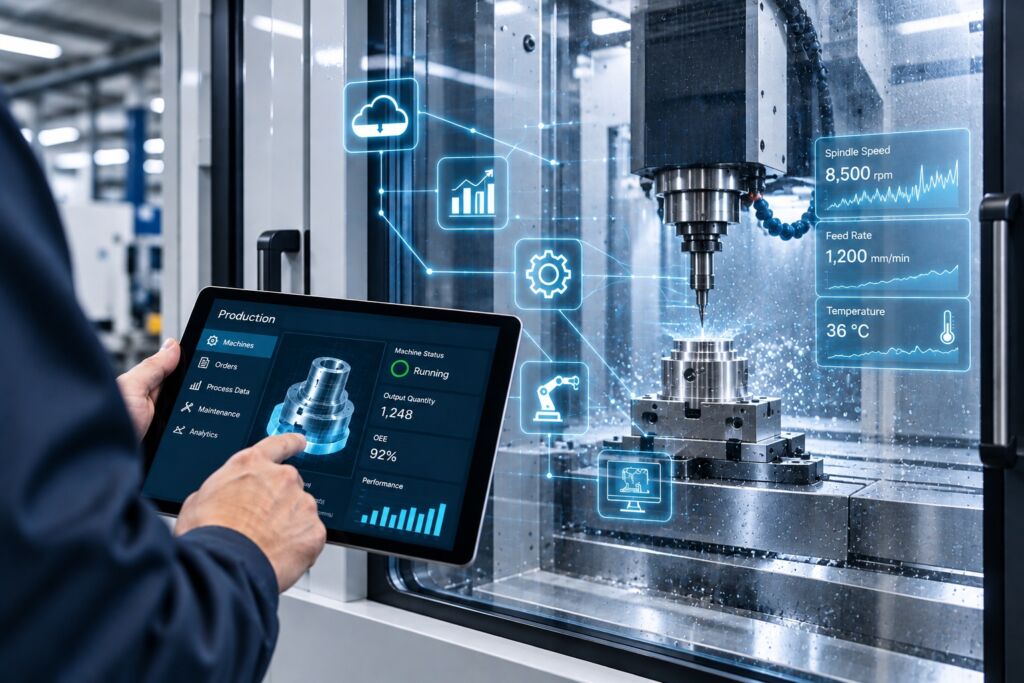
In der industriellen Praxis zeigt sich der Nutzen von SLMs vor allem in ihrer schnellen Anpassbarkeit an konkrete Aufgaben. Während das Feintuning großer KI-Modelle mehrere Wochen dauern kann und eine entsprechende Recheninfrastruktur erfordert, lassen sich SLMs in wenigen GPU-Stunden auf spezifische Anforderungen trainieren. Dadurch können SLMs gezielt auf den jeweiligen Produktionskontext zugeschnitten werden, beispielsweise für das Erkennen von Musterabweichungen, die Interpretation von Wartungstexten oder das Erfassen domänenspezifischer Fachsprache. NTT Data beschreibt zudem zusätzliche Effizienzgewinne durch parametereffiziente Anpassungstechniken wie die Low-Rank Adaptation (LoRA). Dabei wird das zugrunde liegende Modell nicht komplett verändert, sondern modular erweitert. So lassen sich neue Aufgabenbereiche integrieren oder bestehende Funktionen nachschärfen, ohne das gesamte Modell neu trainieren zu müssen. Neben der technischen Flexibilität wirkt sich der reduzierte Ressourcenbedarf auch direkt auf die Kosten aus. Durch den geringeren GPU-Einsatz, den niedrigeren Energieverbrauch und den Wegfall teurer Cloud-Kapazitäten werden die laufenden Betriebs- und Infrastrukturkosten spürbar gesenkt. Hinzu kommt, dass sich SLMs aufgrund ihres geringen Ressourcenbedarfs auch lokal in Werken betreiben lassen – etwa auf Edge Devices oder in abgeschotteten OT-Umgebungen. Das bedeutet auch, dass kleine Sprachmodelle schnelle Antwortzeiten ohne Umweg über die Cloud ermöglichen, was Abhängigkeiten und Sicherheitsrisiken reduziert.
Welche technischen Voraussetzungen müssen erfüllt sein?
Wie NTT Data weiter mitteilt, ist der Ressourcenbedarf eines SLM so gering, dass bereits handelsübliche Server oder Industrie-PCs für den Betrieb ausreichen können. Viele SLMs basieren auf Open-Source-Technologien und unterstützen gängige Frameworks, was wiederum die Flexibilität erhöht und die Anbindung an bestehende Systeme wie MES, ERP oder SCADA erleichtert. Auch für die Anpassung an domänenspezifische Fachbegriffe oder individuelle Workflows sieht NTT Data überschaubaren Aufwand. Moderne Inferenz-Frameworks wie Nvidia Dynamo oder vergleichbare Runtimes spielen hier eine zentrale Rolle. Sie sorgen mit intelligenten Scheduling-Algorithmen dafür, dass mehrere kompakte Modelle gleichzeitig und effizient auf der vorhandenen Hardware ausgeführt werden können. Auch das Ausrollen und Aktualisieren von Modellen wird durch standardisierte Schnittstellen und Automatisierung vereinfacht.
Wo liegen die Grenzen kleiner Modelle und wie lassen sie sich umgehen?
Komplexe Inferenzketten, mehrdeutige Anfragen oder kreative Textgenerierung können die Kapazitäten eines SLM überschreiten. Auch bei mehrsprachiger Verarbeitung oder logischem Schlussfolgern sind größere Modelle meist überlegen. Viele Unternehmen begegnen diesen Grenzen mit hybriden Architekturen, in denen unterschiedliche Modellgrößen nicht gegeneinander, sondern arbeitsteilig eingesetzt werden. Als einen Ansatz beschreibt NTT Data das ‚SLM-first‘-Prinzip: Dabei übernehmen kleinere zunächst die Bearbeitung aller Aufgaben, die sich klar strukturieren, spezialisieren oder automatisieren lassen – etwa das Extrahieren technischer Informationen, die Beantwortung wiederkehrender Anfragen oder die Umwandlung von Formaten. Nur wenn diese SLMs an inhaltliche oder logische Grenzen stoßen, wird ein LLM als ‚Fallback-System‘ aktiviert – beispielsweise für mehrdeutige Fragestellungen, komplexe Planungsszenarien oder kontextreiche Dialoge. Durch ein intelligentes Routing werden Anfragen dabei dynamisch an das am besten geeignete Modell weitergeleitet. NTT Data nennt aufgrund des gestuften Vorgehens mehrere positive Effekte: Rechenressourcen werden geschont, Antworten bleiben nachvollziehbar und kontrollierbar und die Systeme lassen sich zielgerichteter optimieren – sei es durch Finetuning der SLMs oder durch gezielte Prompt-Strategien beim LLM.
Wie werden kleine Modelle trainiert und woher bekommen sie ihre Daten?
SLMs sind keine völlig eigenständige Modellklasse, sondern entstehen in der Regel durch die gezielte Reduktion großer Sprachmodelle. Die Basis bleibt dabei stets ein künstliches neuronales Netzwerk mit Transformer-Architektur, das für Aufgaben der natürlichen Sprachverarbeitung trainiert wurde. Die Umwandlung eines LLM in ein schlankeres Modell erfolgt durch eine Kombination technischer Verfahren, die das ursprüngliche Netzwerk komprimieren, vereinfachen oder durch gezieltes Neudesign ersetzen. Ein gängiger Ansatz ist die Wissensdestillation (Knowledge Distillation): Ein großes Modell dient als Referenz, während ein kleineres Modell darauf trainiert wird, dessen Vorhersagen nachzuahmen. Statt auf Rohdaten zu lernen, orientiert sich das SLM also direkt am Verhalten des größeren Modells, was Trainingseffizienz und Ergebnisqualität verbessert. Neben den klassischen Verfahren gewinnen auch neue Architekturansätze wie Attention-Mechanismen an Bedeutung. NTT verweist jedoch darauf, dass bei KI immer eine Feinabstimmung mit maßgeschneiderten Datensätzen und kontinuierliche Verbesserungen wichtig ist. Hier kommt das Prinzip des KI-Data-Flywheel ins Spiel: Dieses Schwungrad schafft eine Schleife, dank der die Modelle durch die Integration von institutionellem Wissen und Nutzer-Feedback kontinuierlich verbessert werden. Während die KI Ergebnisse generiert, sammelt sie Feedback und neue Daten, die dann zur Verfeinerung und Verbesserung des Modells verwendet werden. Mithilfe von Techniken wie Domain Adaptive Pretraining (DAPT) und Supervised Fine-Tuning (SFT) lassen sich dem SLM dann domänenspezifisches Wissen und aufgabenspezifische Fähigkeiten hinzufügen.
Welche Rolle spielen SLMs in Bezug auf KI-Agenten?
Agenten sind darauf ausgelegt, unterschiedliche Aufgaben zu übernehmen und eigenständig Entscheidungen zu treffen. Laut NTT Data profitieren sie dabei besonders von einem hybriden Architekturansatz: LLMs übernehmen übergeordnete Funktionen wie Kontextverständnis oder strategische Planung, während spezialisierte SLMs operative Aufgaben abarbeiten – ähnlich dem Microservices-Paradigma in der Softwareentwicklung: anstatt einen monolithischen Codeblock zu pflegen, wird die Anwendung in unabhängige, klar abgegrenzte Dienste zerlegt. Jeder Service – oder in diesem Fall jedes Modell – ist auf eine spezifische Funktion optimiert und kann unabhängig angepasst, ausgetauscht oder erweitert werden. So entsteht eine KI-Architektur, die anpassbar, skalierbar und fehlertolerant ist. Ein zusätzlicher Nutzen dieser Struktur: Agenten erzeugen bei ihrer Arbeit fortlaufend aufgabenspezifische Nutzungsdaten, die sich ideal zur kontinuierlichen Weiterentwicklung der beteiligten SLMs eignen. Da diese Daten reale Arbeitsabläufe, domänenspezifische Begriffe und unternehmensspezifische Entscheidungslogiken widerspiegeln, sind sie oft wertvoller als generische Trainingsdaten. Durch gezieltes Finetuning entstehen mit der Zeit echte Expertenmodelle, die nicht nur Aufgaben erledigen, sondern sie mit zunehmender Präzision und Fachkenntnis bewältigen.
„Small Language Models eröffnen der Industrie neue Wege, KI gezielt, sicher und ressourcenschonend einzusetzen. Gerade in der Fertigung sind es in der Regel nicht die größten Modelle, sondern die am besten trainierten, die den Unterschied machen“, sagt Oliver Köth, CTO bei NTT Data DACH. „Wir sehen bereits heute, wie Unternehmen ihre Produktionsdaten mit speziell trainierten Modellen lokal auswerten, wie Wartungsteams sich über sprachgesteuerte Assistenzsysteme unterstützen lassen oder wie technische Dokumente automatisch klassifiziert werden – direkt am Ort des Geschehens. Das Entscheidende ist: Mit SLMs lässt sich KI in den industriellen Alltag integrieren, ohne komplexe Cloud-Setups, ohne Datenrisiken, aber mit hoher Effizienz.“